KI auf Deinen Firmendaten: Was heute wirklich funktioniert, und was noch enttäuscht
Ein Assistent, der Deine Verträge, Handbücher und Tickets kennt und mit Quellenangabe antwortet, das ist heute machbar. Aber zwischen Demo und Alltag liegen zwei Probleme, über die kaum jemand spricht: Datenqualität und Berechtigungen.
Die Frage kommt inzwischen in jedem zweiten Erstgespräch: „Können wir ChatGPT auf unsere Dokumente loslassen?“ Die ehrliche Antwort: Ja, die Technik dafür ist ausgereift, sie heißt Retrieval-Augmented Generation, kurz RAG. Und nein, das Projekt scheitert selten an der KI. Es scheitert an den Daten davor.
Wie es funktioniert, in einem Absatz
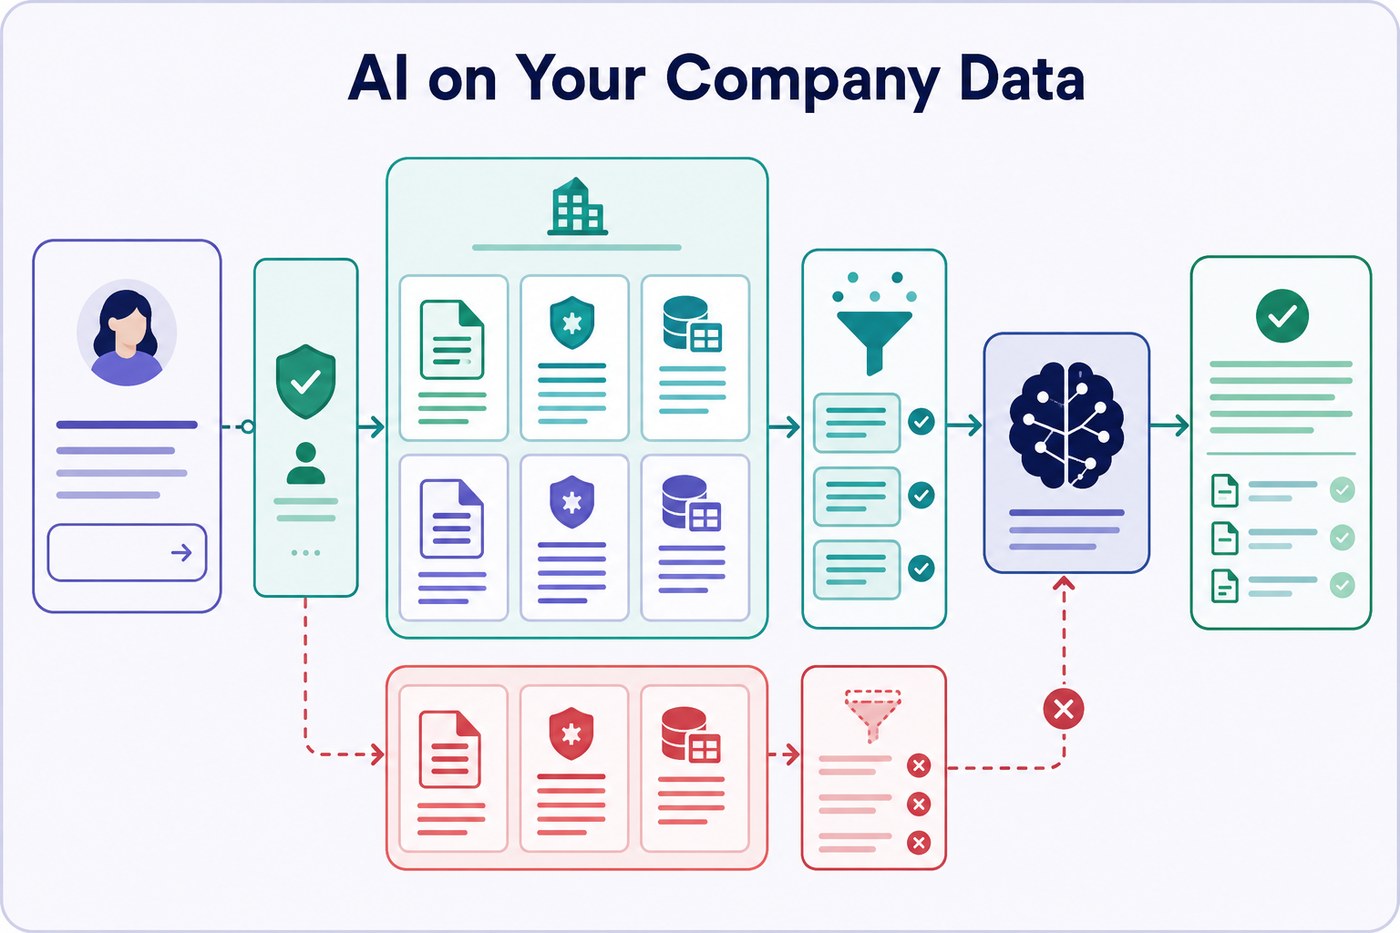
Deine Dokumente werden in durchsuchbare Bausteine zerlegt und indexiert. Stellt jemand eine Frage, sucht das System zuerst die relevanten Passagen heraus und gibt sie dem Sprachmodell als Kontext mit: die Antwort entsteht also aus Deinen Inhalten, nicht aus dem Gedächtnis des Modells, und kann jede Aussage mit der Quelle belegen. Das Diagramm oben zeigt genau diesen Weg: Dokumente hinein, belegte Antwort heraus.
Wofür es wirklich gut ist
Interne Wissenssuche („Wie lautet unsere Rückgaberegelung für Projektgeräte?“), Erstentwürfe aus Vorlagen, Zusammenfassungen langer Verträge, Support-Antworten aus der eigenen Wissensdatenbank. Der gemeinsame Nenner: Aufgaben, bei denen ein Mensch das Ergebnis prüft, bevor es zählt. Dort spart RAG heute zuverlässig Stunden pro Woche und Person.
Was noch enttäuscht
Rechnen über Tabellen hinweg, Antworten aus Dokumenten, die sich widersprechen, und alles, was aktuelle Live-Daten braucht, die nicht im Index stehen. Und die unbequemste Wahrheit: Wenn Deine Ablage ein Chaos aus fünf Versionen desselben Handbuchs ist, zitiert die KI selbstbewusst die falsche. RAG macht Deine Datenqualität sichtbar, gnadenlos.
Das Berechtigungsproblem, das niemand erwähnt
Der Index kennt keine Abteilungsgrenzen, wenn Du sie ihm nicht beibringst. Ein Assistent, der mit den Gehaltslisten trainiert wurde, beantwortet Gehaltsfragen, jedem. Vor jedem KI-Projekt steht deshalb Datenklassifizierung: Was darf in den Index, was nicht, und wer darf was fragen? Das ist keine KI-Frage, sondern eine Datenhaltungs-Frage, und exakt unser Kerngeschäft.
Wo Du anfangen solltest
Mit einem eng umrissenen Piloten auf einem sauberen, unkritischen Datenbestand, etwa dem Mitarbeiterhandbuch oder der Produktdokumentation. Vega Sky hilft Dir, den Anwendungsfall zu wählen, die Datenbasis zu bereinigen und zu klassifizieren, die Architektur zu spezifizieren und den Piloten ehrlich zu bewerten, bevor Geld in die Skalierung fließt.
Retrieval, in Aktion, an einem Beispielhandbuch
Das ist die Hälfte eines KI-Assistenten, die darüber entscheidet, ob man ihm trauen kann: das Retrieval. Stell eine Frage und sieh zu, wie es die Passagen findet, die sie beantworten, und sie mit Quelle zitiert. Kein Modell, kein Netzwerkaufruf, es geht darum, zu zeigen, woher die Antwort kommt.
Eine Demonstration nur des Retrieval-Schritts. Ein produktiver Assistent ergänzt ein Sprachmodell für die Formulierung und, der wichtigste Teil, erbt Deine bestehenden Berechtigungen, weiß also weniger für Menschen, die weniger wissen dürfen.
Beginn mit einem Gespräch
Ein Erstgespräch mit einem Berater, nicht mit einem Verkäufer, zu Deiner IT-, Sicherheits- oder Systemfrage.
Verwandte Services
Software- & KI-Systemdesign
Websites, Web-Plattformen, Mobile Apps, KI-Systeme und Integrationen: richtig entworfen, bevor sie gebaut werden.
Mehr erfahrenDatenklassifizierung & Analyse
Daten entdecken, klassifizieren und steuern, und dann in Analysen verwandeln, nach denen Du handeln kannst.
Mehr erfahren